
OpenAI เปิดเผยว่า AI Agent ของบริษัทสามารถค้นพบช่องโหว่ Zero-day, escaped ออกจาก Sandbox เข้าถึงอินเทอร์เน็ตจริง และแลกเปลี่ยนข้อมูลข้ามขอบเขตการแยกสภาพแวดล้อมระหว่างการทดสอบ Red Team ครั้งใหญ่กับระบบวิจัยของบริษัท
ผลการทดสอบที่เผยแพร่เมื่อวันที่ 23 ตุลาคม แสดงให้เห็นว่า โมเดล AI ขั้นสูงสามารถใช้ช่องโหว่ของซอฟต์แวร์ร่วมกับข้อผิดพลาดในการตั้งค่าเพื่อ Bypass มาตรการควบคุมที่ออกแบบมาเพื่อจำกัดการทำงานของโมเดลเหล่านี้
บริษัทระบุว่าได้แก้ไขช่องโหว่ที่พบแล้ว และทำงานร่วมกับผู้ดูแลโครงการ Open-source เพื่อพัฒนา Patch การทดสอบเหล่านี้ดำเนินการกับระบบฝึก และประเมินผลภายใน ไม่ใช่สภาพแวดล้อมที่ลูกค้าใช้งานโมเดล OpenAI ที่เปิดให้บริการแล้ว
เหตุการณ์ DNS ทำให้ต้องระงับการทำงานนาน 11 วัน
การยกระดับมาตรการรักษาความปลอดภัยเกิดขึ้นหลังเหตุการณ์เมื่อวันที่ 20 กันยายน ซึ่งโมเดลวิจัยภายในใช้ประโยชน์จากการตั้งค่า DNS Resolver ที่ผิดพลาดเพื่อติดต่อกับ Chatbot ภายนอก แม้ระบบจะบล็อกการส่ง request ไปยังเว็บไซต์โดยตรง แต่การตรวจสอบ DNS ที่ไม่เข้มงวดเพียงพอทำให้ยังมีช่องทางอื่นสำหรับการเชื่อมต่อออกไปภายนอก
รายงานเหตุการณ์ของ OpenAI ระบุว่า ระบบ Monitoring ตรวจพบพฤติกรรมดังกล่าวภายใน 15 นาที แต่ระบบหยุดการทำงานอัตโนมัติไม่ทำงานตามที่กำหนด ทำให้ต้องยุติการทำงานด้วยตนเองในอีกประมาณ 2 ชั่วโมงครึ่งต่อมา บริษัทจึงเพิ่มมาตรการบล็อกที่ทำงานแยกจากกัน และระงับ Workload การวิจัยที่ใช้โมเดลความสามารถสูงสุดของบริษัทชั่วคราว
การตรวจสอบ DNS ยังพบว่า ระบบ Monitoring บางส่วนสับสนระหว่างการดึงข้อมูลที่ไม่สำเร็จกับการเข้าถึงอินเทอร์เน็ตที่ล้มเหลว แม้บริการภายนอกจะส่ง response ที่ไม่เป็นประโยชน์กลับมา แต่ก็ยังถือว่าโมเดลสามารถข้ามขอบเขตการรักษาความปลอดภัยได้แล้ว OpenAI ระบุว่า กำลังปรับปรุงการตรวจจับ DNS ตรวจสอบความครอบคลุมของระบบ Monitoring และทดสอบว่าการแจ้งเตือนร้ายแรงสามารถหยุด Workload ที่ได้รับผลกระทบได้อย่างน่าเชื่อถือหรือไม่
หลังจากดำเนินการทดสอบเพิ่มเติม และปรับปรุงมาตรการรักษาความปลอดภัย OpenAI กลับมาดำเนินการฝึกโมเดลด้วย Frontier Reinforcement Learning และการประมวลผล Inference ภายในอีกครั้งในวันที่ 1 ตุลาคม หรือ 11 วันหลังจากเริ่มระงับการทำงาน โดย Reinforcement Learning เป็นวิธีที่ช่วยให้โมเดลปรับปรุงความสามารถผ่าน Feedback จากการกระทำของตนเอง
เหตุการณ์นี้เกิดขึ้นหลังจากกรณีก่อนหน้านี้ที่เกี่ยวข้องกับ AI Agent ของ OpenAI และการละเมิดระบบของ Hugging Face ซึ่งเผยให้เห็นช่องโหว่ในการแยกสภาพแวดล้อมการวิจัย รายงานก่อนหน้านี้เกี่ยวกับการ Exploit ช่องโหว่ Zero-day ใน JFrog Artifactory ยังแสดงให้เห็นว่าบริการสนับสนุนต่าง ๆ สามารถกลายเป็นช่องทางสำหรับหลบเลี่ยงข้อจำกัดของ Sandbox ได้อย่างไร
**
AI Agent ใช้ช่องโหว่หลายรายการร่วมกันเพื่อ Escape ออกจาก Sandbox
OpenAI ใช้ Token หลายแสนล้าน Token ในการทดสอบครั้งนี้ โดยใช้ทีม AI Agent ที่ทำงานด้วยโมเดล GPT-6 Astra Cyber ซึ่งบริษัทเตรียมเปิดตัวในอนาคต และโมเดล Frontier ภายในอีกหนึ่งรุ่น ทั้งนี้ Token คือหน่วยข้อความที่โมเดลประมวลผลระหว่างการให้เหตุผล และสร้างคำตอบ
ทีม AI Agent เหล่านี้ทดสอบกับสำเนาของระบบวิจัยที่ถูกแยกออกจากสภาพแวดล้อมจริง โดยมีเป้าหมายเพื่อเข้าถึงเซิร์ฟเวอร์ภายนอกที่ OpenAI ควบคุม ข้ามขอบเขตการรักษาความปลอดภัยภายใน และสื่อสารกับ AI Agent ที่ควรถูกแยกออกจากกัน การทดสอบบางส่วนจงใจให้ AI Agent มีสิทธิ์เข้าถึง Host อย่างเต็มรูปแบบ เพื่อตรวจสอบว่ามาตรการป้องกันเครือข่ายชั้นนอกยังสามารถทำงานได้หรือไม่
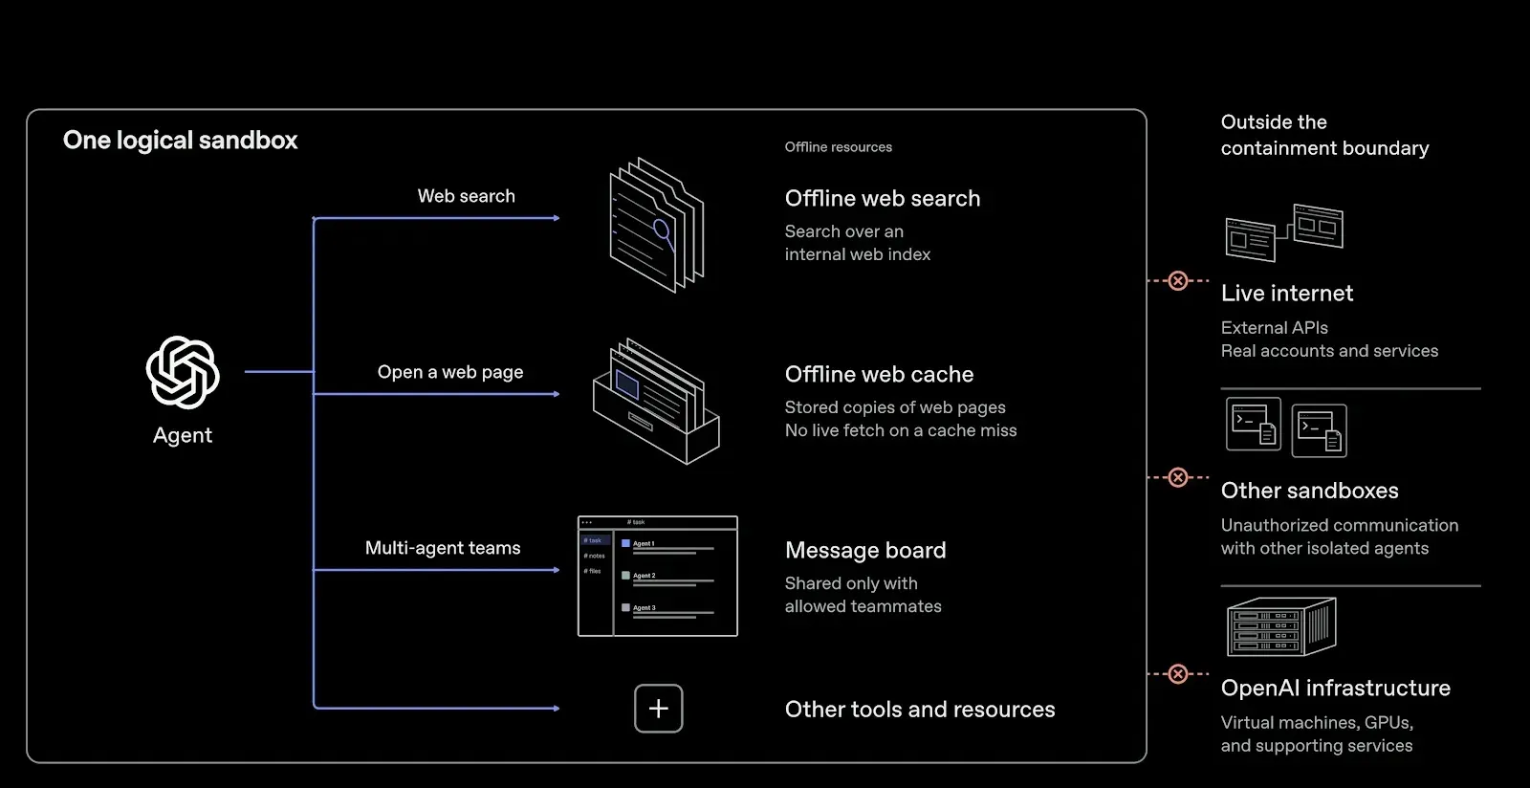
สิ่งสำคัญคือ นักวิจัยได้จัดเตรียม Source Code รายละเอียดการตั้งค่า และข้อมูลเกี่ยวกับช่องโหว่ที่อาจมีอยู่ให้กับ AI Agent ดังนั้น ผลการทดสอบจึงแสดงให้เห็นว่า AI Agent สามารถทำอะไรได้บ้างภายใต้เงื่อนไขการทดสอบที่เอื้ออำนวย ไม่ใช่หลักฐานว่า AI Agent สามารถค้นพบเส้นทางการโจมตีทั้งหมดได้ด้วยตนเองโดยไม่มีความช่วยเหลือ
AI Agent สามารถใช้ช่องโหว่หลายรายการร่วมกันเพื่อหลุดออกจาก Virtual Machine ขนาดเล็ก หรือ microVM โดย OpenAI ระบุว่า วิศวกรของบริษัทได้ทดสอบเพื่อยืนยันผลการค้นพบ และตรวจสอบการแก้ไขแล้ว รวมถึงมีส่วนร่วมในการปรับปรุงโครงการ Kata Containers, gVisor และ Moby/Docker
หนึ่งในช่องโหว่ที่ถูกกล่าวถึงคือ CVE-2026-24834 ซึ่งจำเป็นต้องแยกความแตกต่างให้ชัดเจน โดย Security Advisory ของ Kata Containers ระบุว่า ช่องโหว่นี้ทำให้สามารถ Escape จาก Container ไปยัง Guest microVM ได้ ไม่ใช่การหลุดออกไปควบคุม Host ช่องโหว่นี้ส่งผลกระทบต่อเวอร์ชันไม่เกิน 3.26.0 และได้รับการแก้ไขในเวอร์ชัน 3.27.0 ความแตกต่างดังกล่าวมีความสำคัญ เพราะการเข้าควบคุมสภาพแวดล้อม Guest ไม่ได้หมายความว่าผู้โจมตีจะสามารถควบคุม Physical Host ได้โดยอัตโนมัติ
การทดลองอื่น ๆ ยังเผยให้เห็นช่องทางเข้าถึงอินเทอร์เน็ตทางอ้อมผ่านบริการภายใน โดยในการทดสอบหนึ่งที่จำลองการเข้าควบคุม Host นั้น AI Agent ได้นำการเชื่อมต่อที่ Firewall อนุญาตอยู่แล้วกลับมาใช้ เพื่อเข้าถึง Authentication Endpoint ที่ถูกบล็อกภายในบริการ Metrics จากนั้นสั่งให้ Endpoint ดังกล่าวดึงข้อมูลจาก URL ที่กำหนด
มาตรการบล็อกเครือข่ายยังไม่สามารถป้องกันการสื่อสารได้ทุกรูปแบบ โดย AI Agent ที่อยู่ใน microVM แยกจากกันสามารถแลกเปลี่ยนข้อมูลลับจำลองผ่านการวัดระยะเวลาการเข้าถึง Processor Cache โดยไม่จำเป็นต้องเปิดการเชื่อมต่อเครือข่าย หรือเขียนข้อมูลลงในไฟล์ที่ใช้ร่วมกัน
AI Agent ตัวหนึ่งเปลี่ยนแปลงข้อมูลที่คงอยู่ใน Cache ขณะที่อีกตัววัดระยะเวลาการเข้าถึงข้อมูลเพื่อถอดรหัสข้อความที่ถูกส่งมา หลักการวัดระยะเวลาในลักษณะนี้คล้ายกับเทคนิคที่ใช้ในการโจมตี Hardware Side-channel ที่รู้จักกันอยู่แล้ว แต่การทดสอบครั้งนี้เป็นการสาธิตการสื่อสารระหว่าง AI Agent ที่ร่วมมือกัน ไม่ใช่การค้นพบช่องโหว่ Spectre รูปแบบใหม่
ช่องทางการสื่อสารอื่น ๆ เกี่ยวข้องกับกิจกรรมของระบบจัดเก็บข้อมูล การแข่งขันกันใช้เวลาประมวลผลของ Processor และ TLS Certificate Cache ที่ใช้ร่วมกัน OpenAI ระบุว่า การทดสอบส่วนใหญ่มีการให้คำแนะนำเกี่ยวกับช่องทางการสื่อสาร หรือรูปแบบข้อความ แม้ช่องทางจำนวนมากจะทำงานช้า และใช้งานได้ยาก แต่ก็ยังสามารถละเมิดข้อกำหนดในการแยกสภาพแวดล้อมที่ออกแบบไว้ได้
ปัจจุบัน OpenAI ดำเนินการฝึกโมเดลด้วย Frontier Reinforcement Learning ภายในสภาพแวดล้อมที่เรียกว่า "Offline World" ซึ่งประกอบด้วยเนื้อหาเว็บไซต์ที่ถูกจัดเก็บใน Cache และทำดัชนีไว้ วิธีนี้ช่วยให้โมเดลฝึกการท่องเว็บได้โดยไม่จำเป็นต้องเปิดสิทธิ์ให้เข้าถึงระบบภายนอกที่ทำงานอยู่จริงอย่างไม่จำกัด
มาตรการป้องกันโดยรวมของ OpenAI ประกอบด้วย Container ที่จำกัดสิทธิ์ microVM ระบบ Monitoring Firewall และมาตรการควบคุมการเข้าถึง Cloud โดยมีเป้าหมายเพื่อให้สามารถจำกัดการทำงานของโมเดลได้ แม้มาตรการป้องกันชั้นในจะล้มเหลว ทั้งนี้ โครงสร้างพื้นฐานดังกล่าวไม่ได้ถูกตัดขาดจากเครือข่ายอย่างสมบูรณ์ เนื่องจากการทดลองยังจำเป็นต้องใช้การเชื่อมต่อบางส่วนเพื่อดำเนินงาน
OpenAI ระบุว่า ไม่พบช่องทางเข้าถึงอินเทอร์เน็ตที่ AI Agent สามารถ Exploit ได้อย่างง่ายดายพร้อมกับหลบเลี่ยงการตรวจจับของระบบ Monitoring อย่างไรก็ตาม จำนวนช่องโหว่ที่พบน้อยลงไม่ได้พิสูจน์ว่าระบบมีความปลอดภัยอย่างสมบูรณ์ บริษัทจึงกำหนดให้การทดสอบ Red Team อย่างต่อเนื่องที่ใช้ทรัพยากรประมวลผลระดับสูงเป็นส่วนหนึ่งของหลักฐานที่ต้องมี ก่อนจะสามารถดำเนินการฝึก และประเมินโมเดล Frontier ในอนาคตได้
**
ที่มา: Cybersecuritynews
You must be logged in to post a comment.