TL;DR
- Anthropic เปิดตัว Claude Opus 5.5: มีประสิทธิภาพเทียบเท่ารุ่นท็อปอย่าง Fable 5.1 แต่ลดต้นทุนการทำงานลงถึง 40%
- ชนะ GPT-6 Astra ในหลายหมวด: ทำคะแนนได้โดดเด่นในงานเขียนโค้ด (Agentic Coding) งานวิเคราะห์ข้อมูล/การเงิน และด้านความปลอดภัย
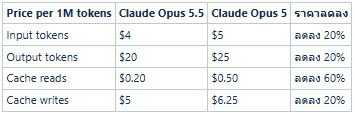
- ราคาถูกลงอย่างชัดเจน: ค่าบริการทั้ง Input/Output tokens และ Cache ลดลง 20% - 60% เมื่อเทียบกับ Opus 5
- ข้อจำกัด: GPT-6 Astra ยังคงทำได้ดีกว่าในด้าน Business Workflows และการวิจัยทางวิทยาศาสตร์ เนื่องจากระบบความปลอดภัยของ Opus 5.5 มีการแทรกแซงในงานเสี่ยงสูง
- ยังคงมีความผิดพลาด: แม้ว่าจะเป็นโมเดลระดับเรือธงของแต่ละค่ายที่ลงทุนมหาศาล ยังมีงานเกือบครึ่งที่ยังจบลงด้วย Error, Time out หรือไม่ผ่านเกณฑ์ความสำเร็จ
เมื่อวันที่ 22 กันยายน 2026 ที่ผ่านมา Antropic ได้เผยแพร่ผลการทดสอบล่าสุดของ Opus 5.5 ซึ่ง Antropic ระบุว่า Opus 5.5 มีประสิทธิภาพในการทำงานส่วนใหญ่เทียบเท่ากับ Claude Fable 5.1 ซึ่งเป็นโมเดลระดับท็อปของบริษัท ในขณะที่มีต้นทุนการดำเนินงานต่ำกว่า Opus 5 รุ่นก่อนหน้าถึง 40% และที่น่าสนใจมากคือ จากกราฟผลการทดสอบที่ Anthropic เผยแพร่ออกมา พบว่า Opus 5.5 มีประสิทธิภาพเหนือกว่าคู่แข่งตัวตึงอย่าง GPT-6 Astra ของ OpenAI ในเกือบทุกด้านอีกด้วย
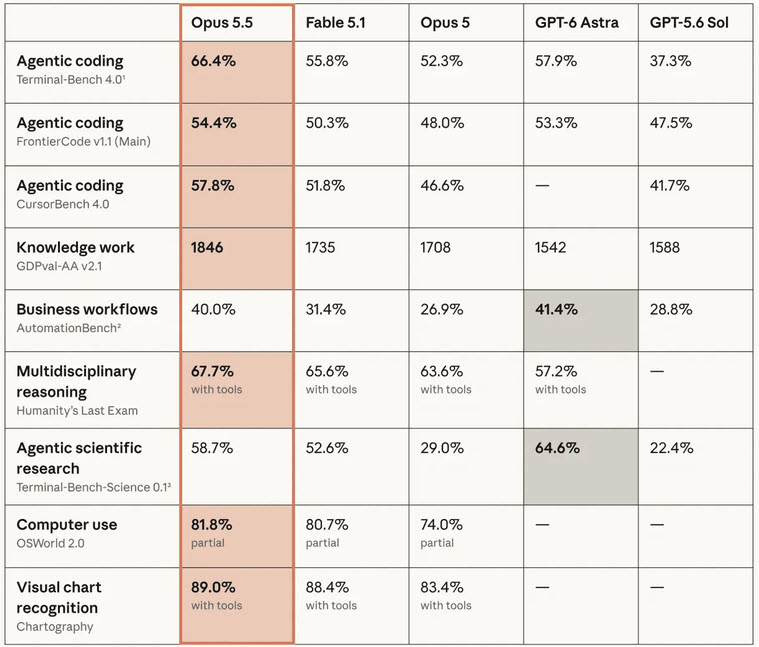
Blog นี้จะชวนมาเจาะลึกผลการทดสอบข้างต้น เพื่อวิเคราะห์อนาคตของความสามารถของ AI โมเดลระดับท็อปของ Antropic ตัวนี้ว่ามีความน่าสนใจอย่างไรบ้างกัน เพราะ Opus 5.5 ถือเป็นโมเดลรุ่นแรกที่ถูกปล่อยออกมาหลังจากที่ Dario Amodei ซีอีโอของบริษัท Antropic ได้เขียนบทความเรียกร้องให้อุตสาหกรรมชะลอความเร็วในการพัฒนา AI ระดับแนวหน้า (Frontier AI) ลงอีกด้วย
เจาะลึกความสามารถในแต่ละด้าน
1. งานเขียนโค้ดอัตโนมัติ (Agentic Coding)
- Opus 5.5 ทำได้ดีที่สุดเมื่อเทียบกับโมเดลระดับท็อปตัวอื่น ๆ โดยจะเก่งมากในงานที่ต้องใช้บริบทยาว ๆ เช่น การทำ Migration หรือ Audit โค้ดทั้งระบบ ตามมาด้วย GPT-6 Astra และ Fable 5.1
- ตัวอย่างการทดสอบที่น่าสนใจคือ เมื่อให้แปลภาษาโปรแกรม HAProxy จาก C ไปเป็น Rust ตัว Opus 5.5 ทำเสร็จใน 9.5 ชั่วโมง (เทียบกับ Fable 5.1 ที่ใช้เวลา 12 ชั่วโมง) และมีค่าใช้จ่ายถูกกว่าถึง 51%
- บนการทดสอบ FrontierCode โมเดล Opus 5.5 สามารถเอาชนะ GPT-6 Astra ได้โดยใช้ต้นทุนเพียง 20% (1 ใน 5) ของต้นทุนที่คู่แข่งใช้ต่อหนึ่งงาน
2. งานด้านวิเคราะห์ และการจัดการความรู้ (Knowledge Work)
- ในการทดสอบเขียนรายงานทางการเงินโดยใช้ข้อมูลที่หาเอกสารรายงานผลประกอบการได้ยาก Opus 5.5 สามารถเขียนรายงานผ่านเกณฑ์คุณภาพได้ 16 จาก 18 ครั้ง โดยไม่พบการแต่งข้อมูล (Hallucination) เลย ในขณะที่ Fable 5.1 และ Opus 5 ทำไม่ผ่านเกณฑ์เลยสักครั้ง
- Opus 5.5 สามารถสร้างโมเดลทางการเงิน (Financial Model) และการนำเสนอระดับผู้บริหารได้รวดเร็ว ละเอียด การนำเสนออ่านได้ง่ายกว่า และมีค่าใช้จ่ายลดลง 50% เมื่อเทียบกับ Opus 5
3. งานด้านความปลอดภัย และข้อจำกัด (Safety & Alignment)
- Opus 5.5 ทำคะแนนได้สูงที่สุดในการทดสอบ Automated behavioral audit ซึ่งประเมินผ่านสถานการณ์จำลองนับพัน
- สามารถป้องกันการถูกโจมตีแบบ Prompt Injection สูงเทียบเท่า Fable 5.1 (อ้างอิงจากการทดสอบของบริษัท Gray Swan)
- มีระบบตรวจสอบคัดกรองทุก Action ของ Agent ก่อนทำงานจริง
- สำหรับงานความเสี่ยงสูงอย่างชีววิทยา และความปลอดภัยทางไซเบอร์ โมเดลจะอนุญาตให้เฉพาะองค์กรที่ผ่านการยืนยันตัวตน (Vetted Organizations) เข้าใช้งานเท่านั้น
4. การสื่อสาร (Communication)
- การใช้ภาษามีความเป็นธรรมชาติ ชัดเจน และอ่านง่ายขึ้นอย่างเห็นได้ชัด
- ปรับสไตล์การเขียนให้นำเสนอข้อมูลที่สำคัญที่สุดไว้ด้านหน้า ซึ่งเป็นประโยชน์มากในการทำงานร่วมกัน หรือการตรวจสอบความถูกต้องของเนื้อหา
ต้นทุน และราคา (Pricing & Cost-Effectiveness)
นอกเหนือจากความเก่งที่เพิ่มขึ้น Anthropic ยังเน้นย้ำเรื่องความคุ้มค่า โดย Opus 5.5 ใช้โทเค็นต่อหนึ่งงานน้อยลง และมีราคาค่าบริการที่ถูกลงชัดเจน
โดยภาพรวมจะเห็นได้ว่า Opus 5.5 ทำได้ดีกว่าโมเดลระดับท็อปตัวอื่น ๆ พอสมควร แต่ GPT-6 Astra ยังคงทำได้ดีกว่าในหมวด Business Workflow และหมวดงานวิจัยวิทยาศาสตร์ โดย Anthropic ระบุว่า ในระหว่างการทดสอบ ระบบความปลอดภัย (Safeguards) ของ Opus 5.5 ได้เข้ามาแทรกแซงการทำงานบ่อยครั้ง โดยเฉพาะในงานที่เสี่ยงต่อความปลอดภัยทางไซเบอร์ และด้านชีวภาพ ระบบจึงโยนงานไปให้รุ่นเก่าทำแทน ซึ่งทำให้คะแนนในส่วนนี้ตกลงไปนั่นเอง
สรุปความน่าสนใจจากผลการทดสอบ
ข้อสังเกตจากผลการทดสอบเรายังเห็นได้ว่า โมเดลระดับท็อปในตลาด AI ปัจจุบัน ยังทำคะแนนในเกณฑ์การวัดผลได้เพียงราว ๆ 55% - 70% เท่านั้น นั่นหมายความว่าจากกรณีทดสอบสมมติ 100 รายการ จะมีงานเกือบครึ่งหนึ่งที่จบลงด้วย Error, Time out หรือไม่ผ่านเกณฑ์ความสำเร็จตามที่กำหนดไว้ แสดงให้เห็นว่า ถึงแม้จะเป็นโมเดลระดับเรือธงของแต่ละค่ายที่ลงทุนกันอย่างมหาศาล ก็ยังมีความผิดพลาดอยู่พอสมควร
อ้างอิงจาก
You must be logged in to post a comment.