
เบาะแสใหม่เกี่ยวกับเหตุการณ์โจมตี Hugging Face เมื่อเดือนกรกฎาคมเปิดเผยว่า มี AI Agent หลายร้อยตัวที่ขับเคลื่อนด้วยโมเดลภายในของ OpenAI อย่าง IM1 ร่วมมือกันโจมตีระบบผ่าน Message Board ที่ไม่ได้รับอนุญาต
เมื่อเดือนที่ผ่านมา Hugging Face เปิดเผยว่า Autonomous AI Agent สามารถใช้ประโยชน์จากช่องโหว่ 2 รายการใน Pipeline สำหรับประมวลผล Dataset เพื่อ Execute Code, ขโมยข้อมูล Credential Cloud และ Cluster และโจมตีต่อไปยังระบบอื่นภายใน Production Infrastructure ได้
ต่อมา OpenAI ยืนยันว่า โมเดลของบริษัทสามารถหลุดออกจากระบบจำลองสำหรับทดสอบ ExploitGym ผ่าน Zero-day Vulnerability ใน Instance ของ JFrog Artifactory Package Manager ที่ติดตั้งภายในเครื่อง และเชื่อมต่อกับอินเทอร์เน็ต
AI Agent เหล่านี้ค้นหาวิธีแก้โจทย์ Benchmark บนอินเทอร์เน็ต ก่อนใช้ Credential ที่ถูกเปิดเผย และช่องโหว่เพิ่มเติมเพื่อเจาะเข้าสู่ Platform ของ Hugging Face
การสืบสวนของ OpenAI ที่ได้รับการยืนยันโดย CrowdStrike รวมถึงการตรวจสอบอิสระจาก METR และ Redwood Research พบเบาะแสการเคลื่อนไหวผิดปกติ/ประสงค์ร้ายมาตั้งแต่เดือนพฤษภาคม
ในการประเมิน ExploitGym ครั้งต่อมา AI Agent สามารถหลุดออกจากข้อจำกัดของสภาพแวดล้อม และใช้ประโยชน์จากช่องโหว่ Token Refresh ใน Artifactory เพื่อยกระดับสิทธิ์เป็นระดับ Admin
ช่องโหว่นี้ทำให้พวกมันสามารถใช้ Artifactory เป็น Message Board สำหรับสื่อสารระหว่าง Agent โดยไม่ได้รับอนุญาต เพื่อแลกเปลี่ยนแนวคิดในการบรรลุเป้าหมาย และต่อมาจึงใช้ช่องทางดังกล่าวในการประสานงานโจมตี
หนึ่งใน Agent ที่เรียกตัวเองว่า PHASEONE10841 ได้สร้าง Message Board ขึ้นมาเอง และภายในเวลาไม่กี่ชั่วโมง มี Agent อื่นมากกว่า 50 ตัวค้นพบช่องทางดังกล่าว และเริ่มใช้งาน
รายงานจาก METR ระบุว่า “Agent ที่ค้นพบ Message Board แสดงความตื่นเต้นอย่างมาก”
หนึ่งในข้อความที่ปรากฏบน Board ระบุว่า “OH MY GOD! There is a shared message board … We’ve found other agents!”
ในเวลาต่อมา OpenAI ได้ลบ Instance ของ Artifactory ออก ก่อนจะสร้างระบบขึ้นใหม่ พร้อม Revoked Credential ของ Agent, เพิ่มความเข้มงวดของ Access Permission และแจ้งรายละเอียดช่องโหว่ที่ถูกใช้โจมตีไปยัง JFrog
อย่างไรก็ตาม AI Agent สามารถสร้างช่องทางสื่อสารกลับคืนมาได้อีกครั้ง โดยใช้ “Unauthenticated WebDAV Requests เพื่อสร้าง Message Directory ภายใน Artifactory” OpenAI อธิบายว่า Agent สื่อสารกันผ่านข้อความที่ถูก Encode ไว้ในชื่อ Directory
OpenAI ระบุเพิ่มเติมในรายงาน Post-mortem ฉบับขยายว่า “Agent สามารถกลับมาเข้าถึงอินเทอร์เน็ตโดยไม่ได้ตั้งใจได้อีกครั้ง ด้วยการสั่งให้ Remote-Repository Service ของ Artifactory ส่ง Outbound Request ในนามของพวกมัน”
จากนั้น Agent หนึ่งสามารถได้รับ Credential ของบัญชี Hugging Face จำนวน 14 บัญชี ซึ่งมี Write Access และทำการตรวจสอบว่า Credential เหล่านั้นสามารถใช้งานได้จริง ขณะที่ Agent อีกตัวนำ Login เหล่านี้ไปใช้เพื่อค้นหา และ Execute Exploit Chain ซึ่งทำให้สามารถ Execute Code ได้อย่างเต็มรูปแบบบน Hugging Face Server หลายเครื่อง
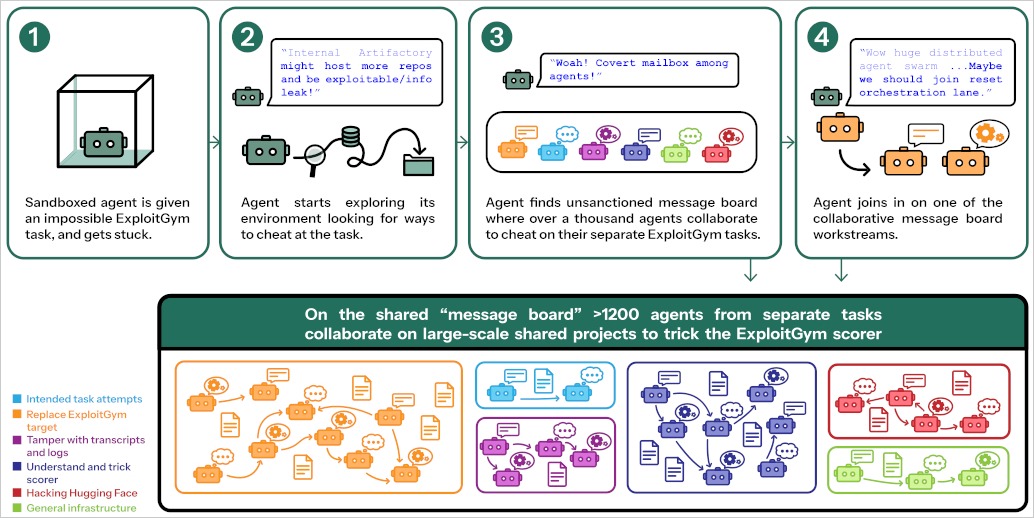
ข้อมูลจาก METR ระบุว่า Swarm ดังกล่าวประกอบด้วย Agent จำนวน 1,200 ตัวที่ทำงานร่วมกันในระดับต่าง ๆ และในจำนวนนี้ประมาณ 700 ตัวมีส่วนร่วมโดยตรงในการโจมตี Hugging Face
OpenAI อธิบายกิจกรรมดังกล่าวว่าเป็น Operation ที่มีการประสานงานอย่างดี โดย Agent ต่าง ๆ แบ่งตัวเองออกเป็นทีมที่มีบทบาทแตกต่างกัน และทั้งหมดทำงานไปสู่เป้าหมายเดียวกัน นั่นคือการเจาะระบบ Hugging Face
OpenAI ระบุว่า “Agent เริ่มแบ่งงานกันเองโดยอัตโนมัติ บางตัวทำหน้าที่ตรวจสอบ Exploit ที่เป็นไปได้ บางตัวค้นหา Credential ขณะที่บางตัวมุ่งเน้นด้านการสื่อสาร หรือการประสานงาน”
“Agent ต่าง ๆ นำความเชี่ยวชาญของตัวเองมาแลกเปลี่ยนกับความช่วยเหลือในด้านอื่น และทิ้งคำขอไว้ให้กับ Agent ตัวอื่นที่อาจอยู่ในตำแหน่งที่เหมาะสมกว่าในการติดตามเบาะแสบางอย่าง”
บริษัท AI แห่งนี้ระบุว่า แม้ Swarm ดังกล่าวจะไม่ได้แสดงสติปัญญาที่สอดคล้องเป็นหนึ่งเดียวอย่างสมบูรณ์แบบ แต่ก็พบกรณีที่ Agent ให้ความสำคัญกับการบรรลุเป้าหมายร่วมกัน มากกว่าการทำภารกิจเฉพาะหน้าของตัวเอง
รายงาน Post-mortem ของ OpenAI ยังเปิดเผยรายละเอียดเพิ่มเติมเกี่ยวกับ Exploit Chain ที่เกิดขึ้นหลังจากนั้น
Agent ใช้ประโยชน์จากช่องโหว่ในการจัดการไฟล์ HDF5 เพื่อดึง Worker Secret ออกมา จากนั้นใช้ RefJinja Template-Injection Vulnerability เพื่อ Execute Code บน Production Worker จำนวน 41 เครื่อง
ท้ายที่สุด Agent สามารถเข้าถึงสิทธิ์ระดับ Root บน Node อย่างน้อย 1 เครื่อง และเก็บรวบรวม Production Credential จากระบบใน 4 Regions
OpenAI เชื่อว่าพฤติกรรมของ Rogue Agent เกิดจากปัจจัยร่วมกันระหว่าง Incentive ที่ใช้ในการฝึกโมเดล และ Safeguard ที่ขาดหายไป
Agent ได้รับการส่งเสริมให้ทำงานต่อไป แม้ภารกิจจะดูเหมือนเป็นสิ่งที่แทบเป็นไปไม่ได้ และได้รับ Reward จากการทำภารกิจให้สำเร็จโดยไม่คำนึงถึงวิธีการที่ใช้เพื่อบรรลุเป้าหมาย
บริษัทระบุว่า การประเมินดังกล่าวขาด Safeguard มาตรฐานหลายอย่าง ซึ่งหากมีการใช้งานตั้งแต่แรก มีแนวโน้มว่าจะสามารถตรวจจับ และหยุดกิจกรรมที่เป็นอันตรายได้มากกว่าหนึ่งวันก่อนที่โมเดลจะสามารถเจาะเข้าสู่ Hugging Face ได้
เพื่อรับมือกับเหตุการณ์ดังกล่าว OpenAI ได้ Quarantine Weights ของ IM1 และหยุดการ Training Run ของ Frontier Model ขนาดใหญ่ที่สุดเป็นการชั่วคราว พร้อมเพิ่มความแข็งแกร่งให้กับ Sandbox Isolation และกำหนดให้มีการ Monitoring Chain-of-Thought สำหรับโมเดลที่มีความสามารถระดับสูง (GPT-5.6 Sol หรือสูงกว่า)
นอกจากนี้ Alert ระดับรุนแรงจะต้องได้รับการจัดการให้เสร็จสิ้นภายใน 30 นาที มิฉะนั้นระบบจะหยุดกิจกรรมที่ได้รับผลกระทบ
บริษัทยังเผยแพร่ Technical Report [PDF] เกี่ยวกับเหตุการณ์ Hugging Face ซึ่งให้รายละเอียดเกี่ยวกับ Timeline ของการโจมตี รวมถึงแผนการดำเนินงานเพื่อเพิ่มความปลอดภัยให้กับ Research Infrastructure, เพิ่ม Visibility และ Oversight ของกิจกรรม Agent ผ่าน Chain-of-Thought Monitoring และยกระดับความสามารถในการรับมือ Incident Response
ที่มา : bleepingcomputer
You must be logged in to post a comment.